
Japan
サイト内の現在位置
【Oracle×生成AI 第6回】AIエージェント活用を支える新たな選択肢
生成AIの活用が「個人の効率化」から「業務プロセスの変革」へと進むなかで、AIエージェントへの期待が高まっています。一方で、多くの企業が「何から手をつければよいか分からず着手できない」「試してはみたが、そこから先へ進めない」段階で足踏みしているのが実情ではないでしょうか。本記事では、AIエージェントを本番で使い続けられる状態に進めるために越えるべき課題を整理し、それに応える選択肢の一つとしてOracleのOCI Enterprise AIサービス、とりわけEnterprise AI Agentsを紹介します。
目次
1 はじめに
本シリーズではこれまで、生成AIの企業活用に向けた技術と実践を紹介してきました。第3回では、データベースに日本語で問いかけるだけで業務データを取り出せる仕組み(Oracle AI DatabaseのSelect AI Agent)を、第5回ではAIエージェントを継続利用するために欠かせない「記憶管理」を取り上げました。
AIエージェントは、複数のツールやデータを組み合わせて複雑な業務を自律的にこなせる点で、大きな可能性を持ちます。しかし実際には、可能性を試すPoCにたどり着く前に止まってしまう、あるいはPoCまでは進んでも本番運用へ踏み出せないという企業が数多くあります。AIエージェントは従来のチャットボットより構成要素が多く、組み合わせて動かす前提の仕組みであるため、この傾向は一層強く表れます。
要因はさまざまですが、主に次の3つの観点が考えられます。
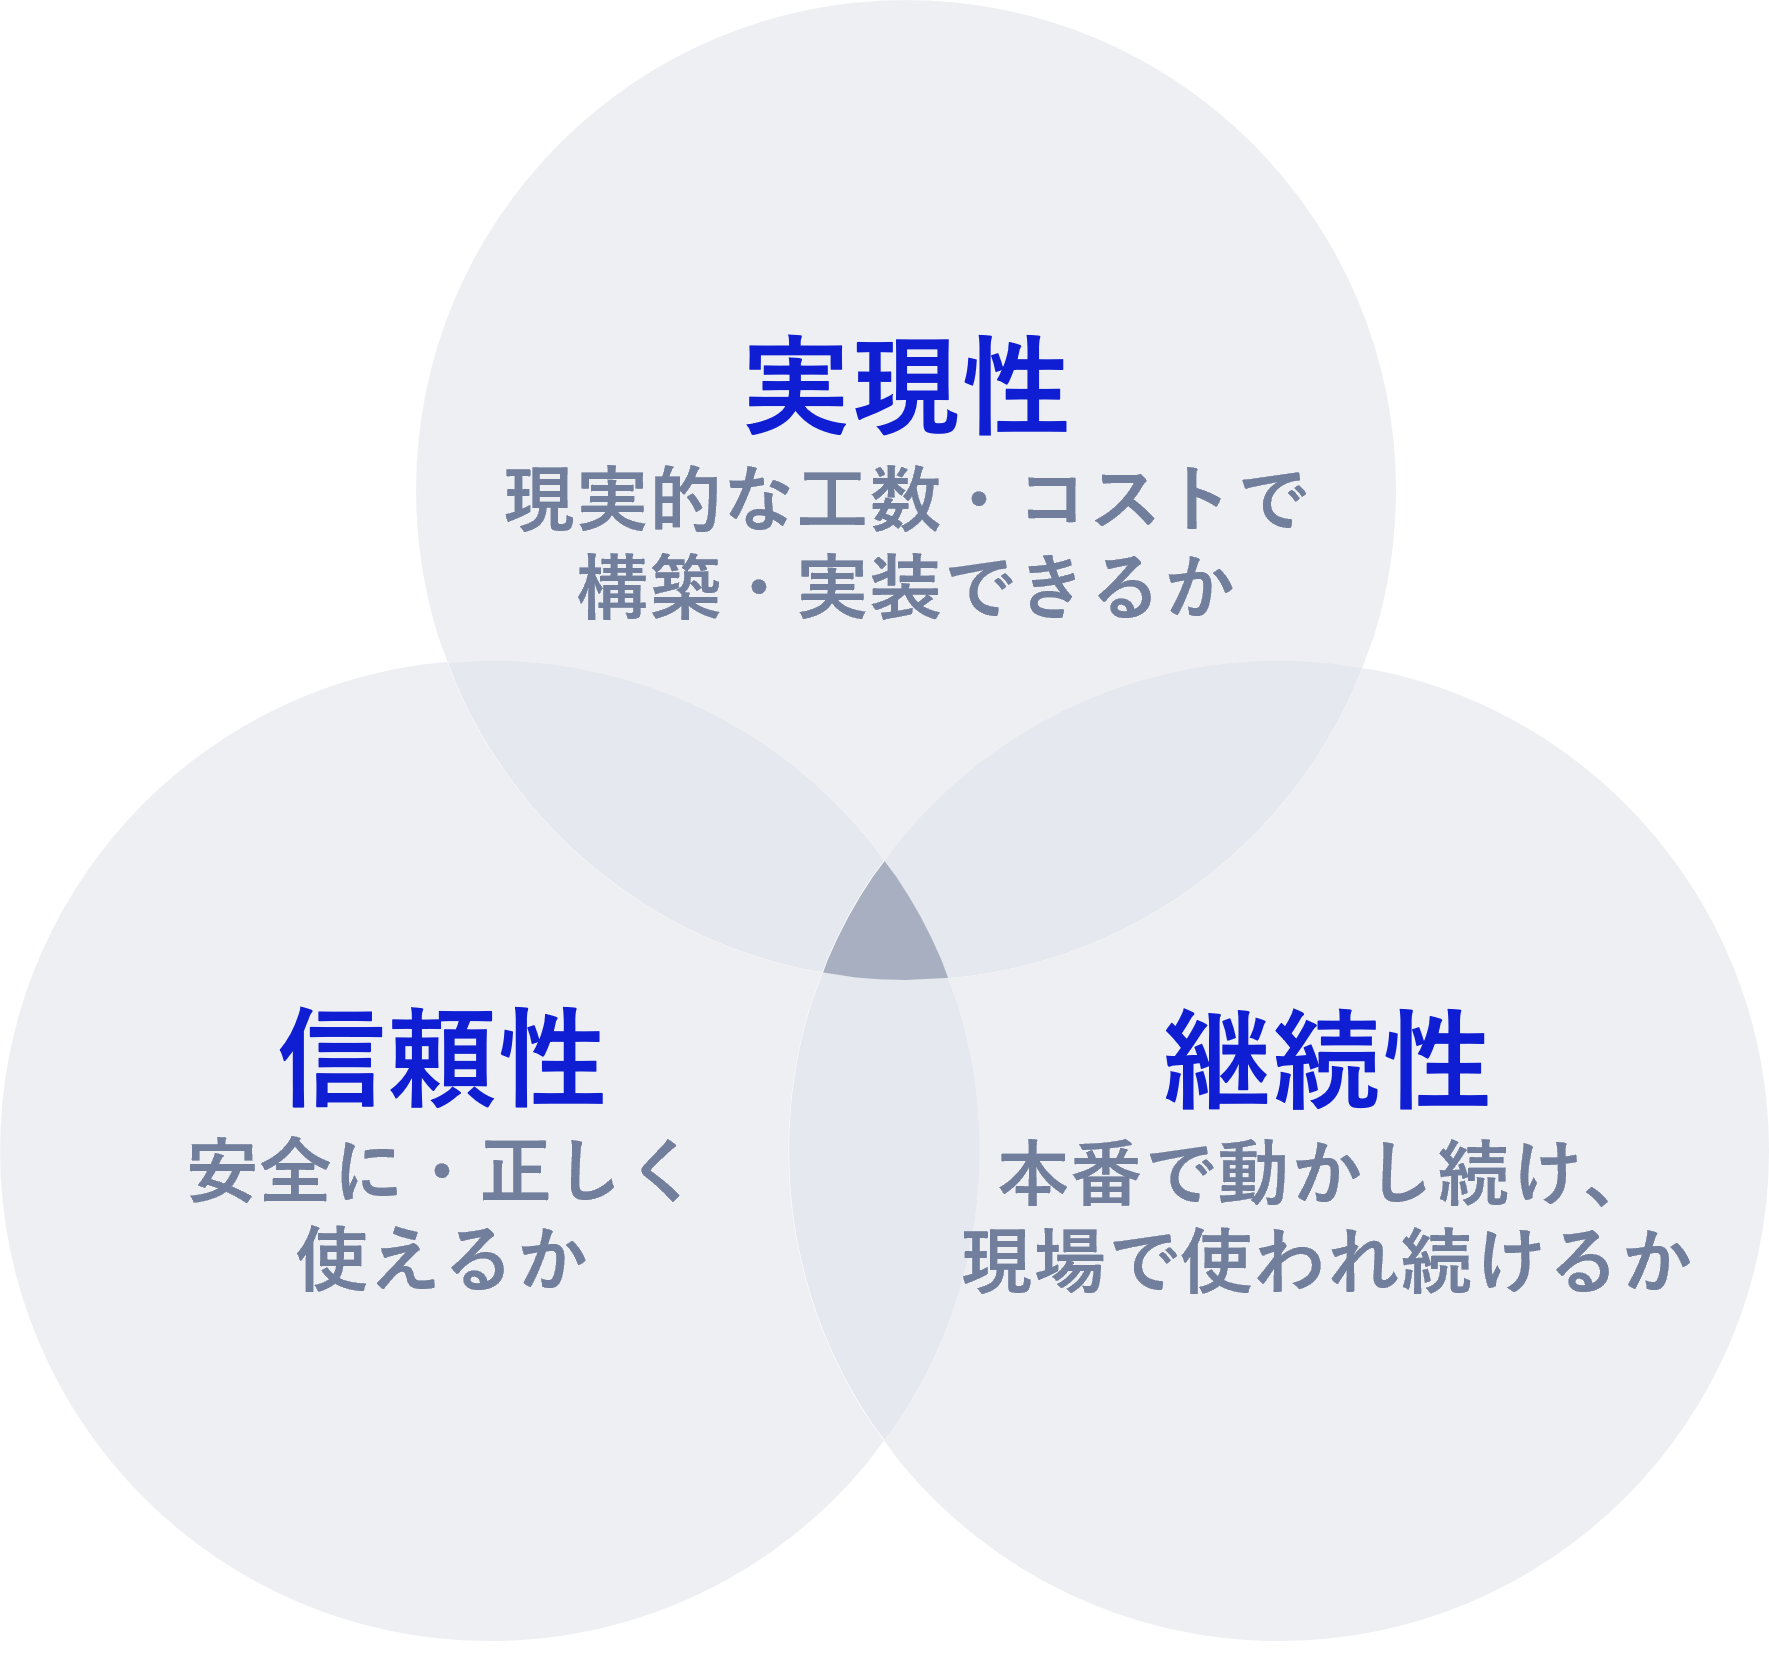
■ 実現性:現実的な時間と人員で構築・実装できるか
- 技術的に、やりたいことを実現する機能が揃っているか。それらを組み合わせてつなげられるか
- 開発できる人材がいるか。工数とコストが見通せるか
■ 信頼性:安全に・正しく使えるか
- 生成AIの回答精度は十分か
- エージェントが使うデータを統制できるか。誰がどのデータにアクセスできるかを制御できるか
- 業務データが意図しない経路で社外に出ない形で使えるか
■ 継続性:本番で動かし続け、現場に使われ続けるか
- 利用者にとって使いやすいものになっているか
- 新しいモデルや機能を取り込み、改善を続けられるか
これらは、AIエージェント本体をどう作るかという話にとどまりません。AIエージェントを業務システムとして成立させるために必要なこと——実行環境、データの統制、継続的な改善——が広く含まれます。こうした課題は一朝一夕には解消できませんが、Oracleが提供するOCI Enterprise AIサービス(旧OCI Generative AIサービス)には、これらの課題に応えるための機能群が用意されています。
2 AIエージェントを活用していく上での壁
AIエージェントへの期待が高まるなかで、多くの企業が共通の壁にぶつかります。1章で挙げた3つの観点に沿って、現場でよく挙がる課題を1つずつ整理します。
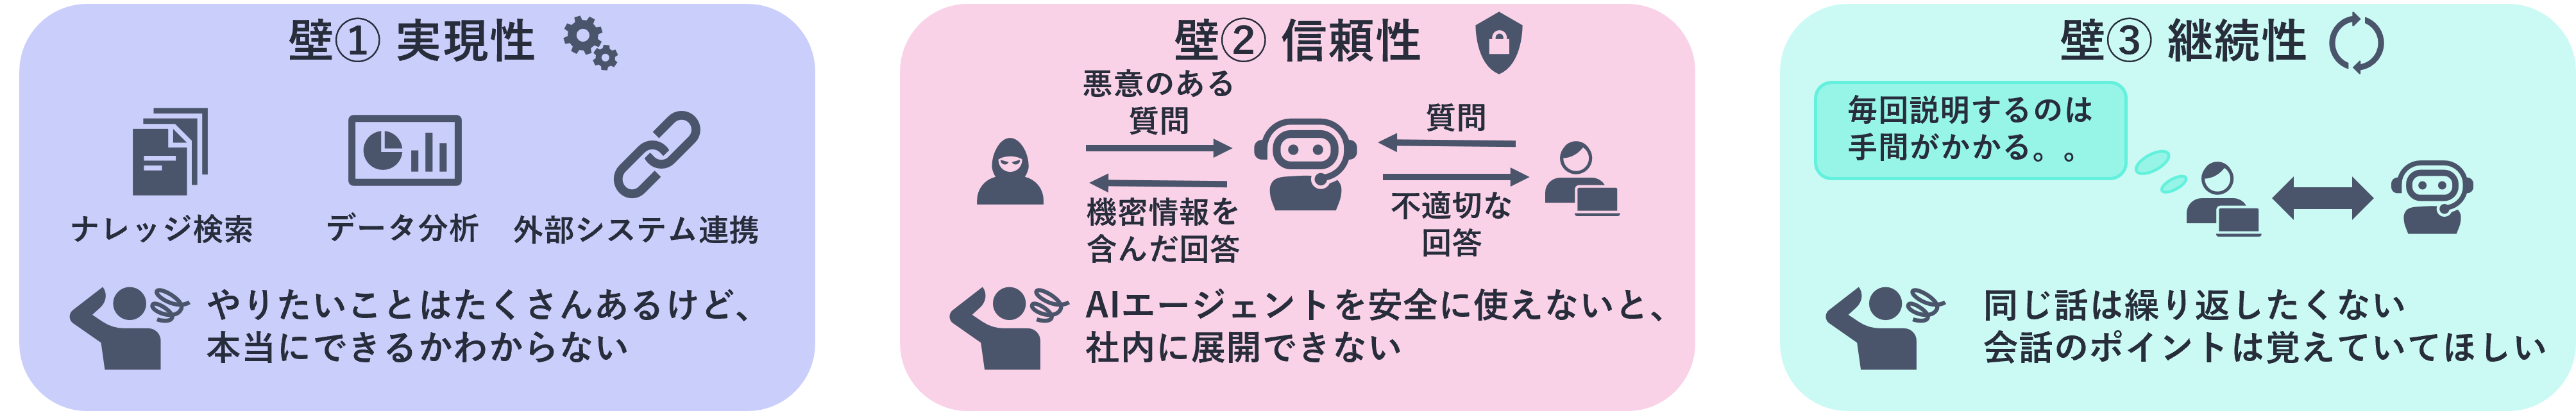
壁①(実現性)「機能開発に時間を取られ、業務利用までたどり着けない」
「社内ナレッジを検索したい」「データを自然言語で分析したい」「外部システムと連携したい」——求める機能を挙げるほど、開発対象は増えていきます。すべてをゼロから作ると、このような問題が出てきます。
- 各機能の開発に工数と期間がかかる
- 機能間のつなぎ込み・整合性の担保に想定以上の時間を取られる
- 動かすための実行環境も自前で用意しなければならない
結果、個々の機能は作れても、組み合わせて業務で使えるところまで到達しないまま費用だけが膨らむ、という事態になりがちです。
壁②(信頼性)「安全に使える確信が持てず、社内に展開できない」
試作段階では問題にならなくても、業務で使うとなれば話が変わります。
- 悪意のある質問がされたときに、データを守れるか
- 生成AIから不適切な結果が返ってきたとき、検知できるか
これらに答えを持てないと、作ったものを社内に出す決裁が下りません。技術的に動くことと、組織として使ってよいと判断できることの間には、隔たりがあります。
壁③(継続性)「PoC環境では良かったのに、実際の業務では使い続けられない」
実際に業務で使い始めると「毎回同じ前提を説明し直す」「担当者が変わると会話が一からになる」といった不満が出ます。これは第5回で扱った記憶管理の課題です。仕組みがなければAIエージェントは毎回「初対面」から始まり、現場が「使い続けたい」と思えず、利用が定着しないことにつながります。
これら3つの壁は、いずれも技術選定だけでは解消できない部分があります。次章では、OCI Enterprise AIサービスがこれらの壁にどう応えるかをご紹介します。
3 OCI Enterprise AIサービスとは
ここからは、以下の記事を参考に、OCI Enterprise AIサービスについて整理します。
[2026 Oracle Technical Deep Dive] エンタープライズAIエージェントを支えるOCIソリューション。ラインナップと特徴を理解しよう! (2026年9月17日開催) - Speaker Deck
3.1 OCI Enterprise AIサービスを支える3つの領域
OCI Enterprise AIサービス(旧OCI Generative AIサービス)とは、企業が生成AIを安全かつ柔軟に業務活用するために役立つ機能を、OCI上で提供するマネージドサービスです。機能は次の3つの領域に整理されています。
- Enterprise AI Models ··· 高性能なLLMをマネージドなサービスとして提供
- Enterprise AI Agents ··· AIエージェントを活用するために必要な機能をまとめて提供
- Enterprise AI Governance ··· AIエージェントを安全に動かす・データを守るためのサービスを提供
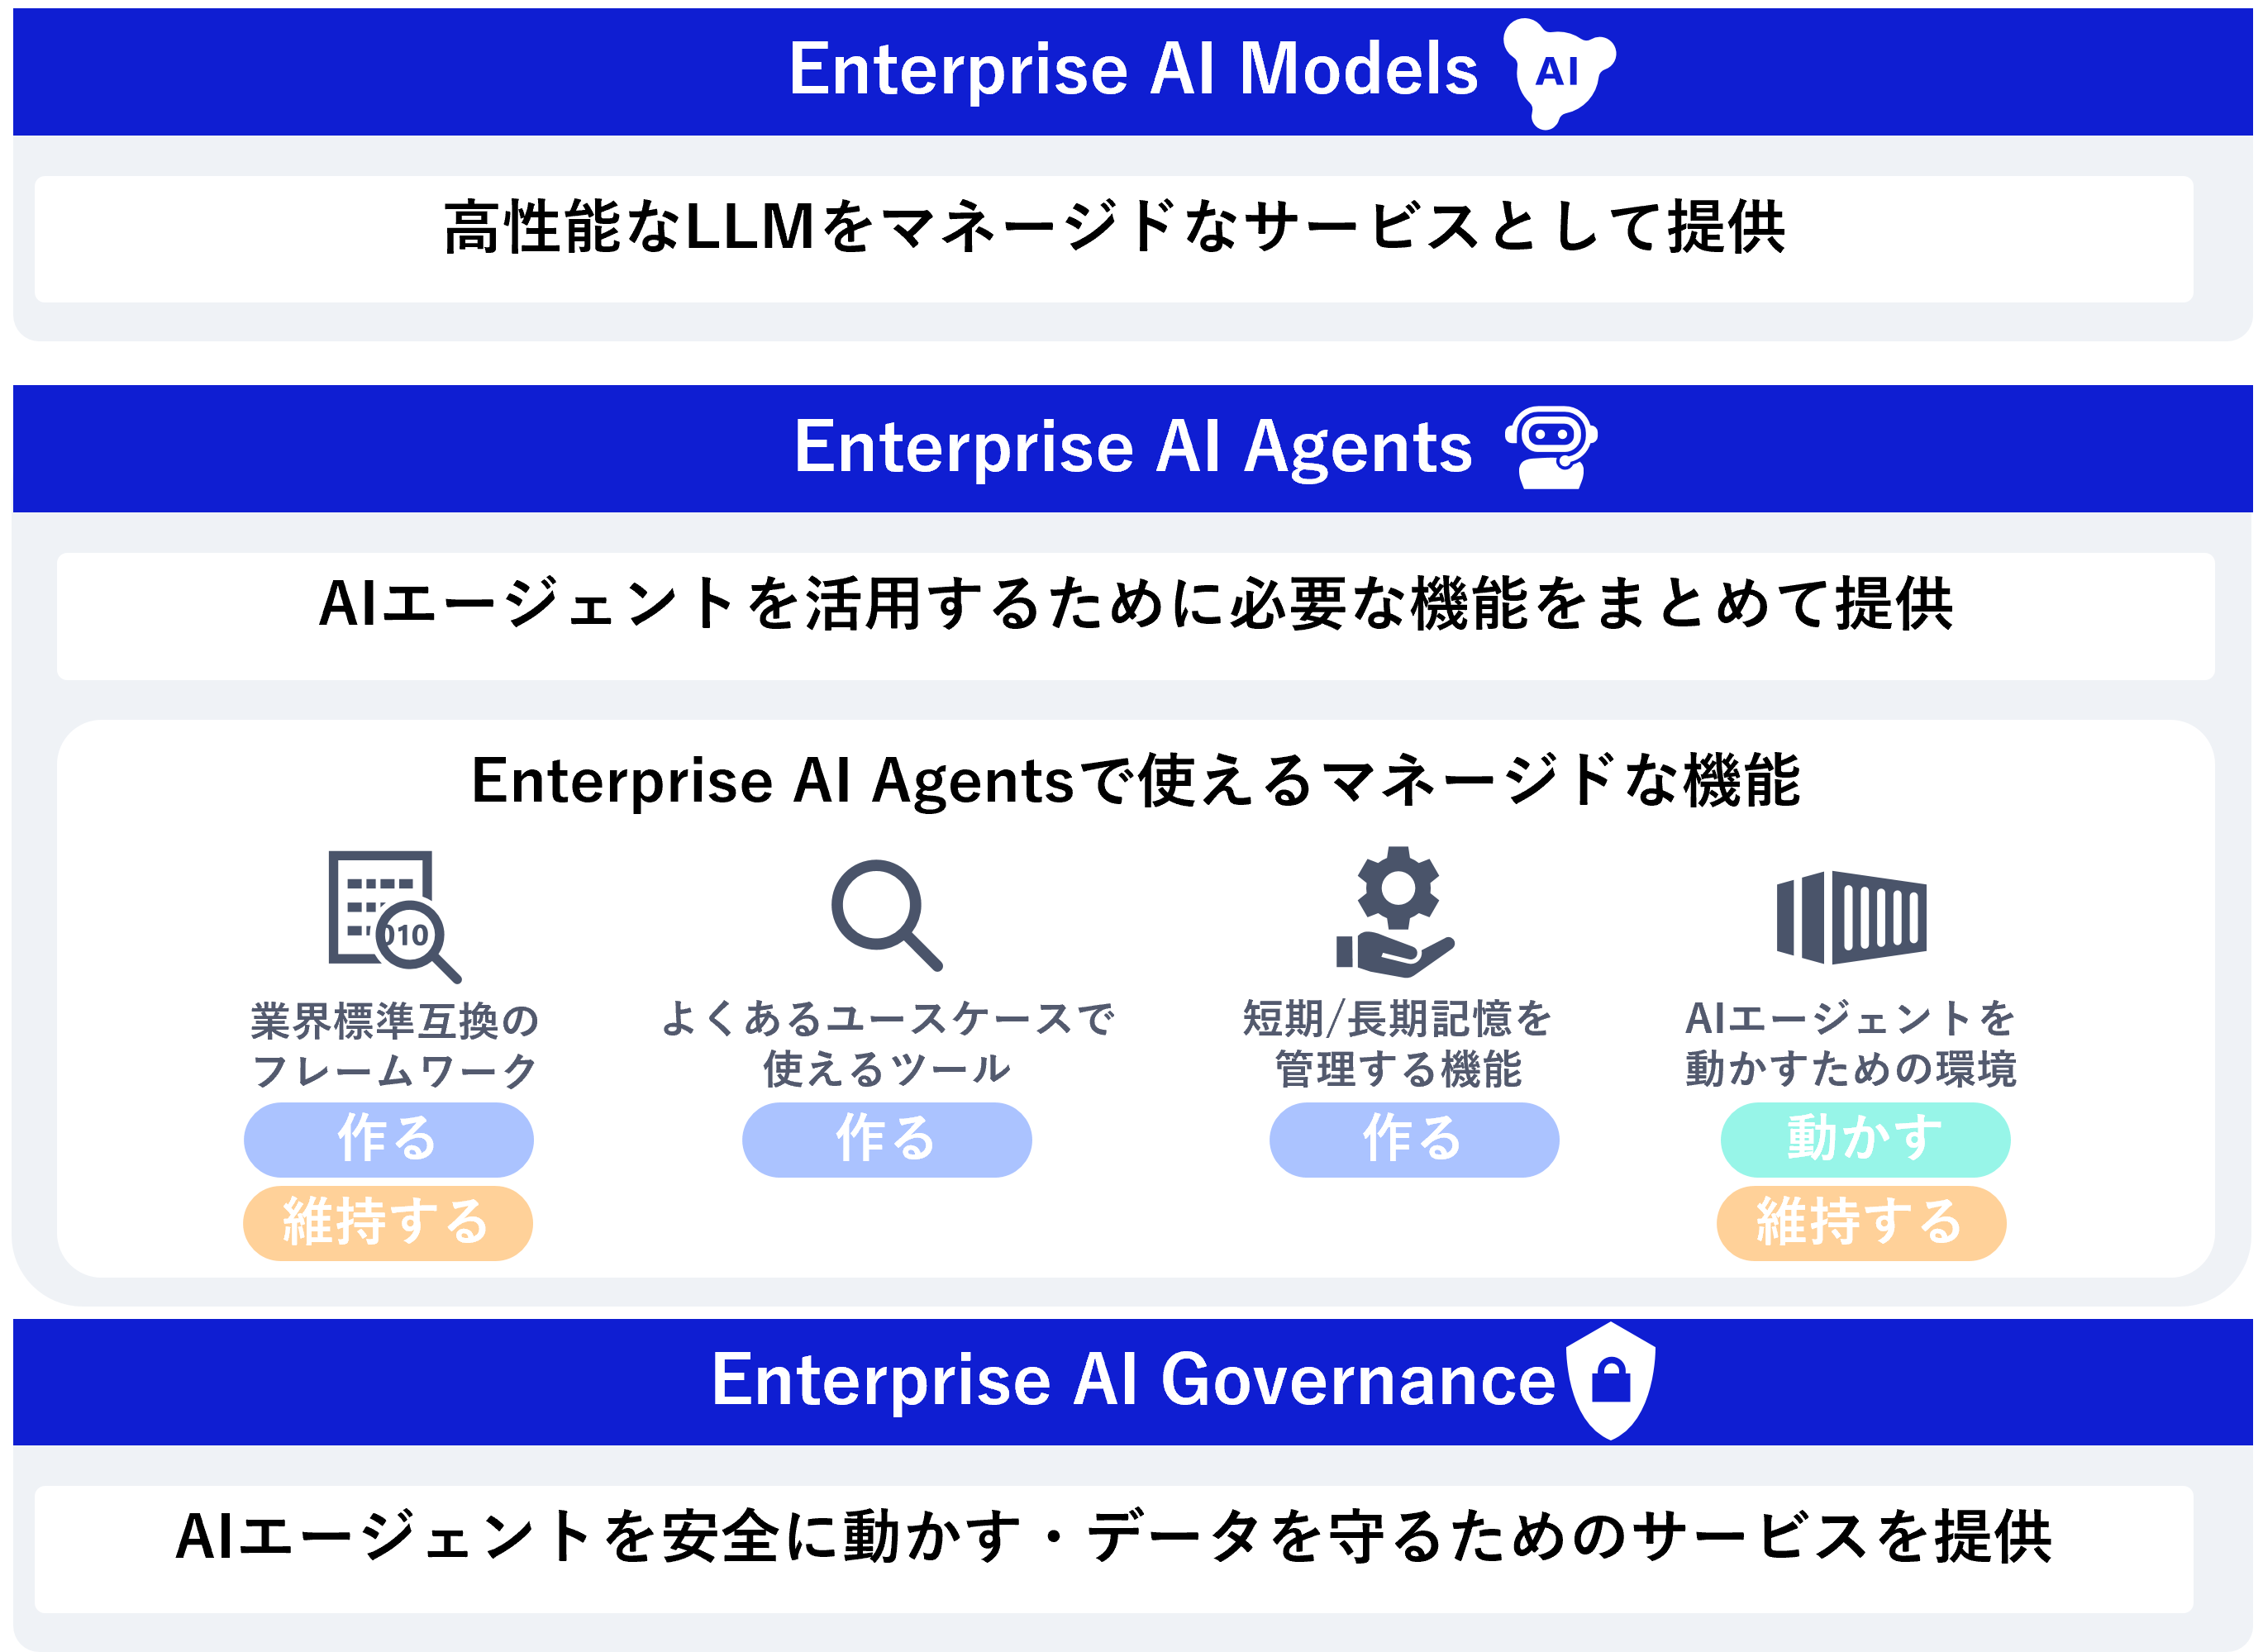
これらは別々のサービスとして契約するものではなく、一つのサービスの中で機能を分類したものです。
いずれも、生成AIやAIエージェントを企業データと組み合わせて利用するうえで必要となる機能です。
3.2 3つの壁への対応
ここからは、2章で挙げた3つの壁に対して、OCI Enterprise AIサービスがどう応えるのか、順番に見ていきます。

壁①(実現性)への対応 ― 使えるものを起点に、作る範囲を絞る
Enterprise AI ModelsとEnterprise AI Agentsが効く領域です。ポイントは次の4つです。
- AIモデルは用意されたものを使える ··· 生成AIのモデルを自前で用意する必要がありません
- よく使う機能は用意済み ··· 社内資料の検索や、他のシステムを呼び出す機能などが、Enterprise AI Agentsにあらかじめ用意されています
- 慣れた書き方のまま開発できる ··· 呼び出し方は業界標準であるResponses APIと互換性があり、既存の開発資産や人材を活かせます
- 動かす環境も用意しなくてよい ··· 作ったものをコンテナにして配置(デプロイ)すれば、実行環境と呼び出すための窓口(URL)が自動で用意されます。利用量に応じて処理能力を自動で増減させることもできます
「何でも自前で作る」から「使えるものは使い、必要な部分だけ作る」へ切り替えることで、AIエージェントそのものの改善に時間を使えます。
壁②(信頼性)への対応 ― 統制の仕組みはOracle側に用意されている
こちらはEnterprise AI Governanceが受け持つ領域です。生成AIへの入力と出力の両方をチェックする「ガードレール」の機能が用意されており、次のような内容を検知できます。
- 悪意のある指示(プロンプト・インジェクション)··· システムの動作を書き換えたり、データを不正に引き出したりしようとする指示
- 不適切な内容 ··· 差別的・暴力的な表現など、利用ポリシーに反する内容
2章で挙げた「悪意のある質問からデータを守れるか」「不適切な結果を検知できるか」に、自社で仕組みを作らずに備えられます。
壁③(継続性)への対応 ― 記憶管理で「使い続けられる」AIエージェントをつくる
会話の流れや利用者に関する情報の管理を、Oracle側に任せられます。難しい実装は不要です。会話履歴の管理は、払い出される会話IDを渡して会話を続けるだけで、自動的に行われます。いったん画面を閉じても前回の続きから対話でき、現場が「このエージェントは自分の業務を分かっている」と感じられることが、日常業務への定着につながります。
OCI Enterprise AIサービスは、構築・統制・継続利用という本番化に直結する課題に対して、具体的な手段を提供します。次章では、Enterprise AI AgentsとEnterprise AI Modelsを使って、実際の業務でどのように動くのかを、具体的なシナリオをもとにご紹介します。
4 ユースケースで見る活用イメージ
本章では、Enterprise AI AgentsとEnterprise AI Modelsを使って実際に構築したAIエージェントを、シナリオ・構成・実装・動作結果の順にご紹介します。
4.1 シナリオ
A社では、毎月の売上傾向の把握と、その背景にある要因の分析を定期的に行っています。販売に関わる情報をOracle AI Database(Autonomous AI Database)上で管理しており、売上データの取得はSelect AI Agentを活用することで、自然言語で必要なデータを取り出せるようになっていました。
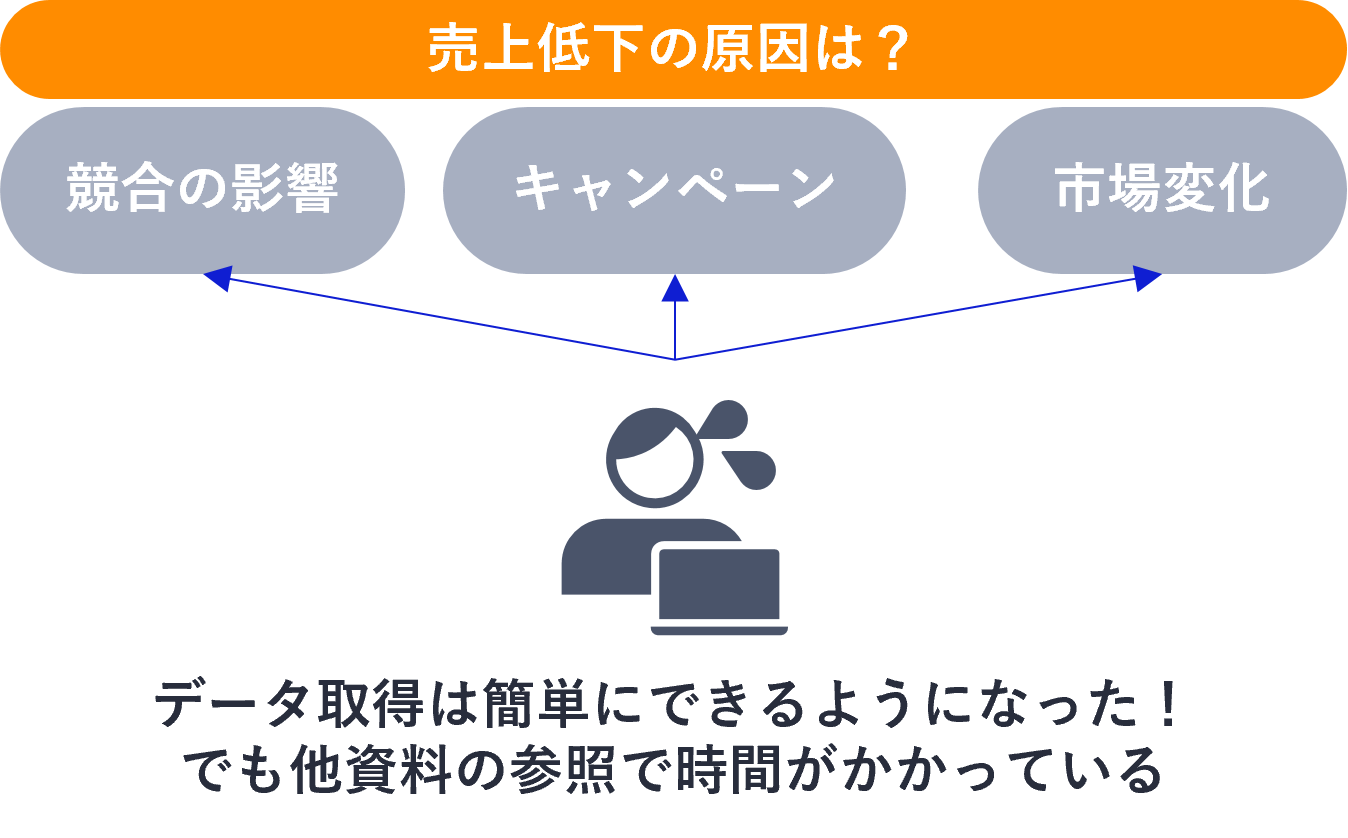
しかし課題はその先にありました。「なぜこの時期に特定カテゴリの注文が減ったのか」「競合他社の動向と関係があるのではないか」——売上傾向の背景を探るためには、別途用意した競合他社情報のまとめ資料を開き、関連しそうな箇所を自分で探し出して照らし合わせる作業が必要でした。データの取得と資料の検索を行き来しながら分析をまとめるこの作業は、担当者にとって時間と手間のかかるプロセスでした。
このプロセスを改善するために、今回はAIエージェントが自律的に処理できる構成を実現します。
4.2 構成
今回構築したのは、「売上データを取得するタスク」と「競合情報を取得するタスク」という2つのタスクを実行する売上分析エージェントです。

売上分析エージェントを作るにあたり必要な機能に対して、今回どのように対応したかを整理すると、次のとおりです。
| 必要な機能 | 今回 |
|---|---|
| 売上データの取得 | Select AI Agentを呼ぶ処理だけ実装。 データ取得部分の作り込みは不要(既存のSelect AI Agentにお任せ) |
| 競合資料の検索 | 標準のツールを宣言するだけ |
| 質問に応じた情報源の使い分け | 役割と使い分けのルールを指示として書く |
| 会話履歴(記憶)の管理 | 払い出された会話IDを利用 |
ここで注目したいのは、新たに作り込んだ部分がわずかで済んだ点です。競合情報の検索や、会話履歴の管理はEnterprise AI Agentsで既に実装済みのものを利用したため、作り込みは行っていません。また、売上データの取得も、標準の関数呼び出しツールで既存のSelect AI Agentを呼び出すことで、今ある資産を活用した実装となっています。
4.3 実装とデプロイ
では、どのように形にして動かしたのかを具体的に説明します。実施したことは、次の2つです。

1. アプリ(売上分析エージェント)の開発
前節で挙げた、エージェントの役割と使い分けの指示、Select AI Agentを呼び出す処理を、1つのPythonプログラムに書きました。これがAIエージェントの本体になります。書いたコードは、ポイントだけ見ると次のとおりです。
A:run_sql
売上分析エージェントが利用者の質問をもとに作った問い合わせ文を、既存のSelect AI Agentに渡す部分です。Select AI AgentはそれをSQLに変換してデータベースから売上データを取り出し、結果をエージェントに返します。これを関数呼び出しツールとして売上分析エージェントに渡します。
# A. 自社で作り込んだ部分:既存の Select AI Agent を呼び出す
def run_sql(query: str) -> str:
with get_connection() as connection:
with connection.cursor() as cursor:
cursor.execute("BEGIN DBMS_CLOUD_AI_AGENT.SET_TEAM(:team); END;",
team="SELECT_AI_TEAM")
cursor.execute("SELECT DBMS_CLOUD_AI_AGENT.RUN_TEAM(:team, :prompt) FROM DUAL",
team="SELECT_AI_TEAM", prompt=query)
...
# 関数呼び出しツールの宣言
RUN_SQL_TOOL = {"type": "function", "name": "run_sql",
"description": "Autonomous Database 内の注文・売上データに
自然言語で問い合わせ、結果を返す。",
"parameters": {...}}
B:file_search
競合資料の検索の部分です。あらかじめ競合資料をベクトルストアに登録しておけば、質問に関係する箇所を探し出す処理はEnterprise AI Agentsが行い、見つかった内容をAIモデルに渡して回答に使わせます。そのため自社では検索の処理を書かず、どのベクトルストアを使うかを宣言するだけで済みます。
# B. そのまま使えた部分:ファイル検索ツールは宣言するだけ
FILE_SEARCH_TOOL = {"type": "file_search", "vector_store_ids": [VECTOR_STORE_OCID]}
C:responses.create
A・Bの2つのツールと役割の指示を渡して、AIモデルを呼び出す部分です。最初の質問のときに会話IDを1つ払い出し、2回目以降は同じ会話IDを渡すだけで、会話履歴が引き継がれます。
# C. 会話IDは最初の1回だけ払い出す
if not conversation_id:
conversation_id = client.conversations.create().id
# 2つのツールと役割を渡して実行。2回目以降も同じ会話IDを渡す
response = client.responses.create(
model=MODEL,
tools=[RUN_SQL_TOOL, FILE_SEARCH_TOOL], # ← 使うツールを宣言
instructions=("あなたはビジネスアナリストです。"
"売上・注文などデータベースに関する質問 → run_sql のみ使用する。"
"競合他社・市場動向など外部情報に関する質問 → file_search のみ使用する。"
"インサイト・要因を求められた場合は、両方を組み合わせて回答する。"),
input=user_input,
conversation=conversation_id, # ← 同じ会話IDを渡すと、前回までの文脈を引き継ぐ
)
2. アプリ(売上分析エージェント)の登録と配置
書き終えたプログラムは、コンテナにまとめ、OCI上の保管場所(コンテナ・レジストリ)に登録します。あとはそのコンテナを指定して配置(デプロイ)を指示すると、AIエージェントが動き始め、呼び出すための窓口(URL)が払い出されます。サーバーを調達して構築したり、外部から呼び出せるように公開の設定を作ったりする作業はありません
4.4 動作結果
それでは、実行結果を見ていきます。動作の確認は、OCI上に用意した仮想マシンで簡単な対話用プログラムを動かして行いました。払い出された窓口(URL)に質問を送り、エージェントの回答を受け取っています。次の図は、実行結果を、会話の形に整理したものです。
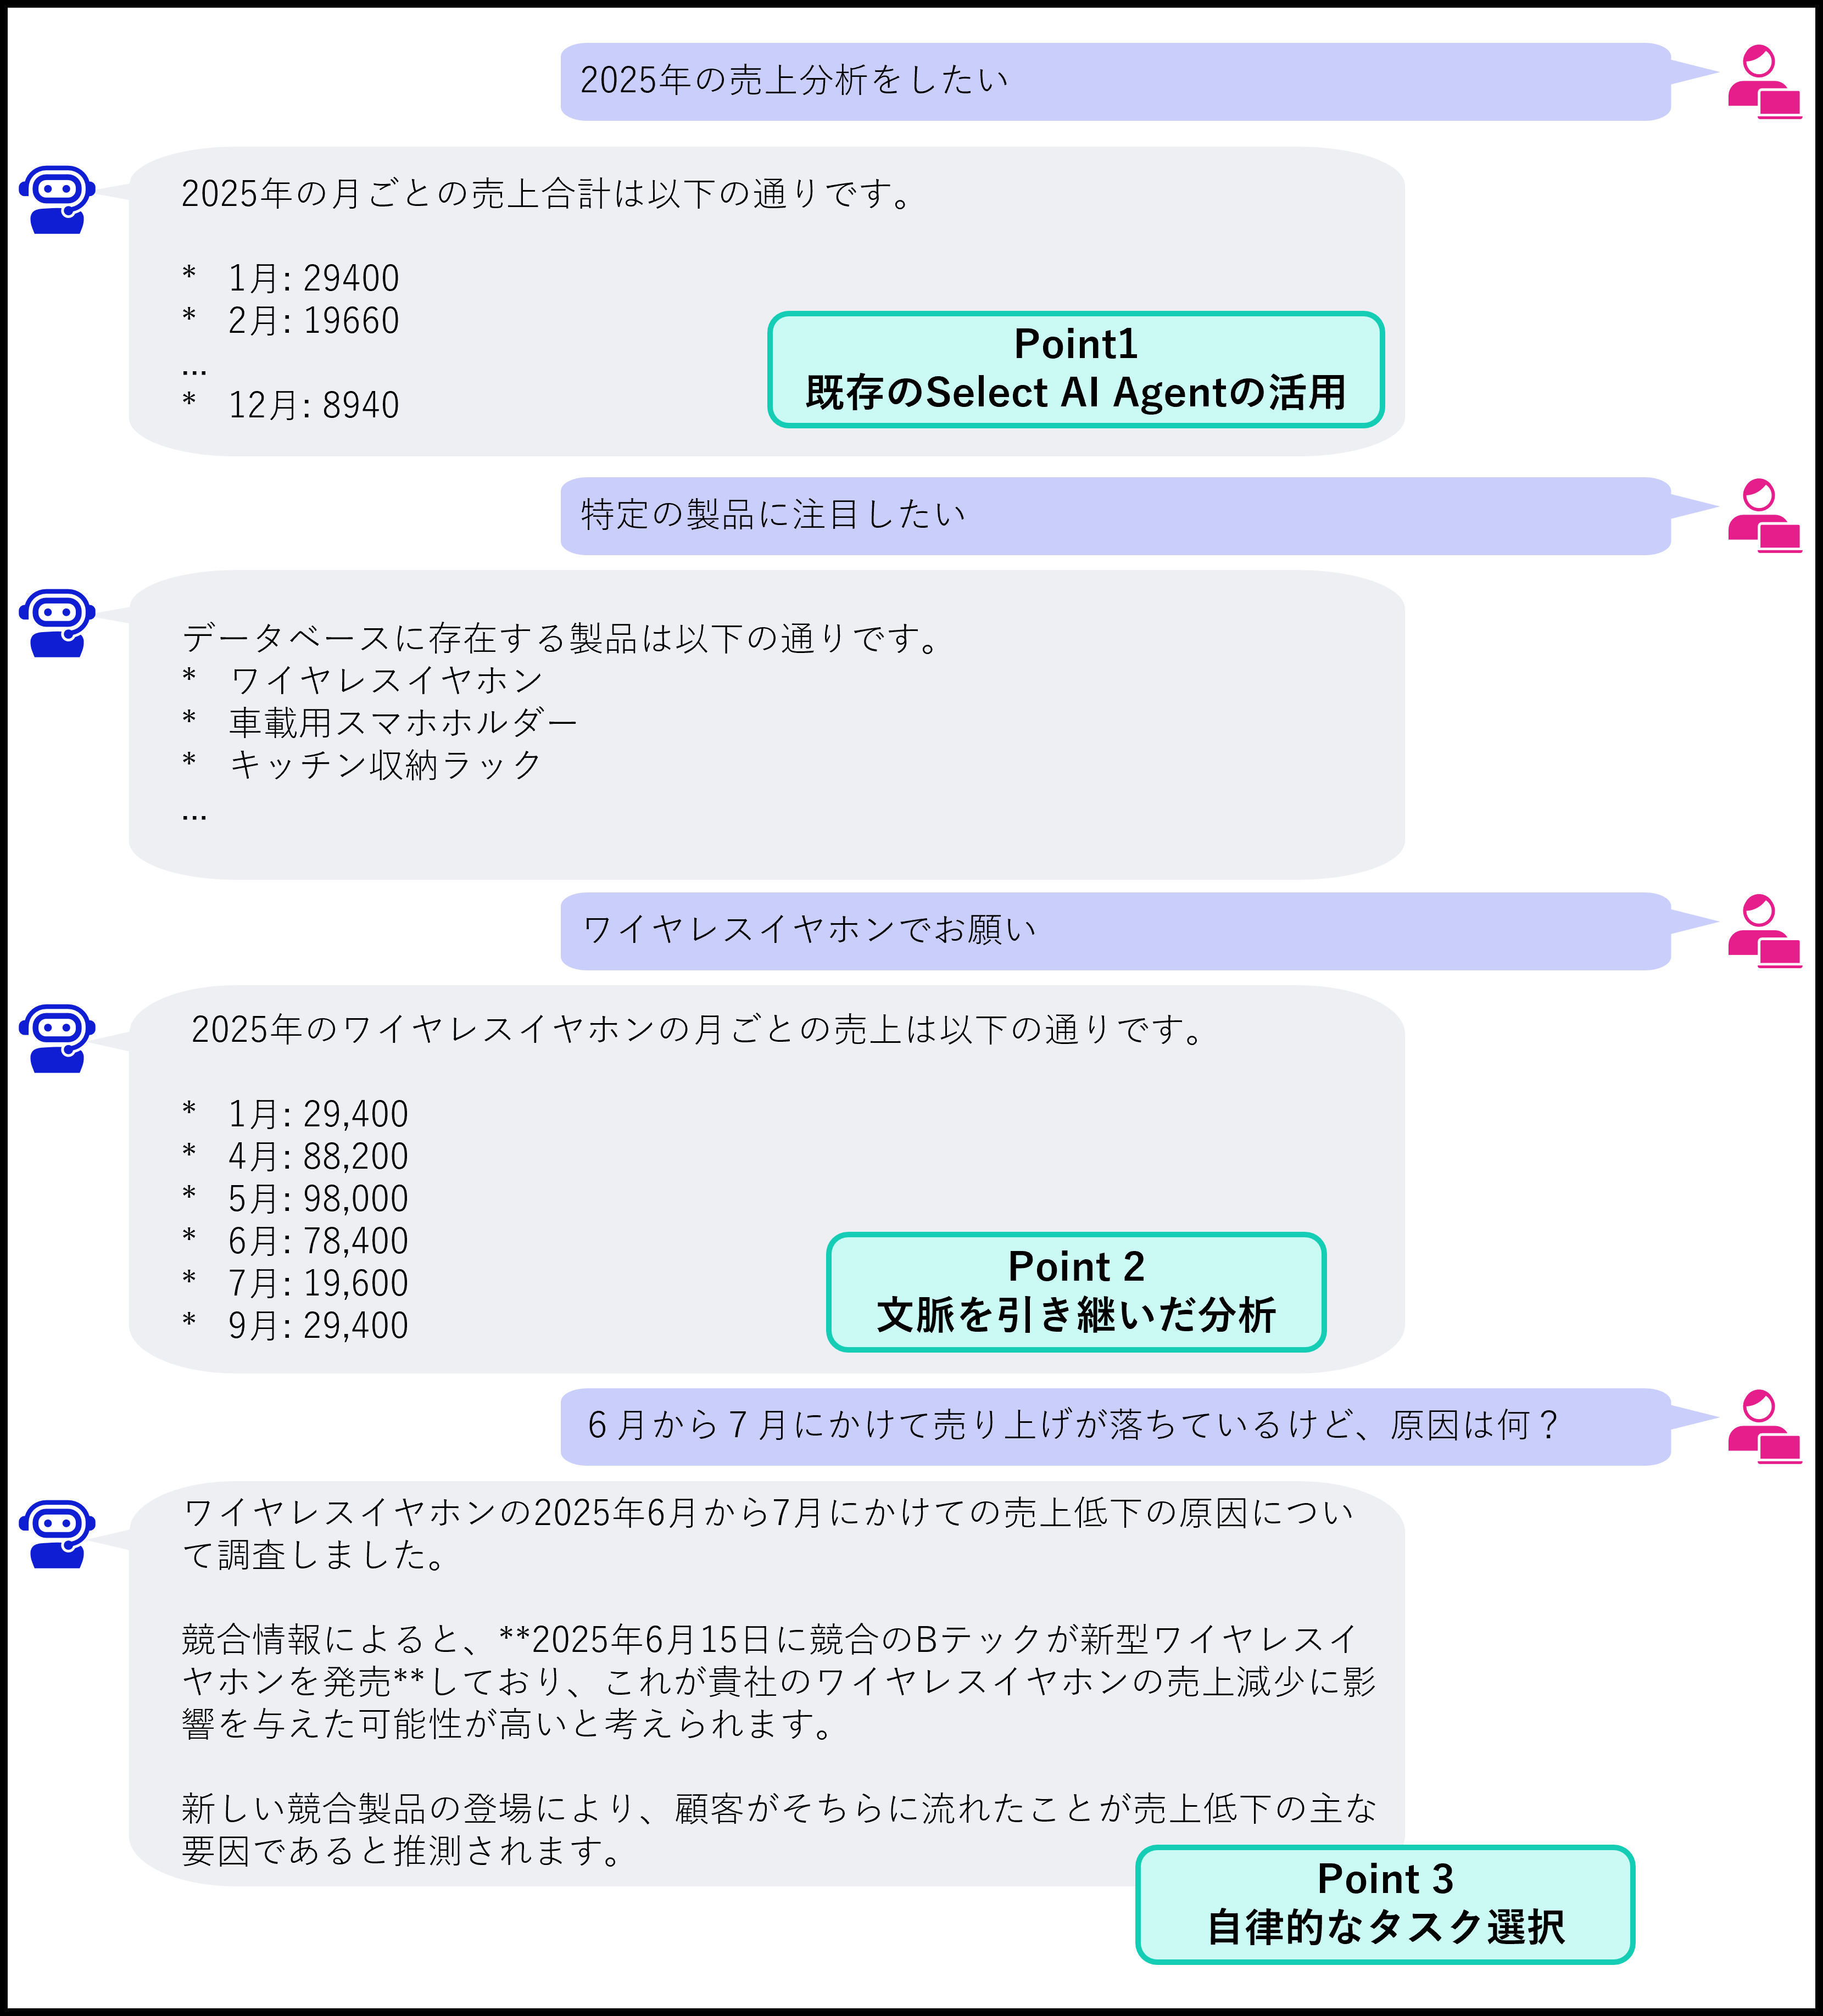
ユーザーが「売上分析をしたい」と問いかけると、売上分析エージェントはどのような分析が可能かを提示します。「2025年のワイヤレスイヤホンの売上を見たい」という流れで対話しながら分析対象を絞り込んでいくと、月ごとの売上データが取得されました。
次に「6月から7月にかけて売上が落ちているけど、原因は何?」と問いかけると、売上分析エージェントは「2025年のワイヤレスイヤホンを見ている」という前の会話の文脈をそのまま引き継ぎ、売上低下の原因を調査します。そして「2025年6月15日に競合のBテックが新型ワイヤレスイヤホンを発売しており、これが影響した可能性が高い」というインサイトを返しました。
この結果から、確認できたポイントは3つです。
- 既存資産をそのまま活かせる ··· 使い慣れたSelect AI Agentを組み込むだけで、作り直しコストがかかりません。
- 説明し直す手間がない ··· 「ワイヤレスイヤホンの」「2025年の」と言い直さずに会話を続けられます。記憶が効いていることがわかります。
- 指示しなくても自律的に動く ··· 「競合も調べて」と頼まなくても、エージェントが判断して社内データと資料を組み合わせます。単なるチャットボットとの決定的な違いです。
このように、既存の資産を活かしながら開発を進められ、会話の文脈は自動的に引き継がれることが確認できました。複数の情報源をAIエージェント自身が判断して組み合わせることもでき、シナリオで求めていたものを実現できています。
5 おわりに
今回は、OCI Enterprise AIサービスに注目しました。共通して必要になる部分はOracle側に任せ、自社は固有の部分に集中する——この考え方は、既存の開発資産やAIエージェントを活かしながら本番化を進めていくための手段の一つとして期待できると感じました。
NECでも、OCI Enterprise AIサービスの各機能の検証を進めながら、業務への活用やお客様へ提供するサービスへの組み込みに向けて検討を進めていきたいと思います。
本記事が皆様の業務効率化や新しい価値創出の一助になりましたら幸いです。
本記事の内容について詳しく知りたい方は、以下よりお問い合わせください。
資料ダウンロード
NECでは、生成AIによる企業データ活用の第一歩をお手伝いするサービスとして、OCI上に生成AIのPoC基盤を構築し、技術支援を行うサービスを提供しております。詳しくは下記の資料をご覧ください。
Oracle Cloud 生成AI PoC環境構築サービス紹介資料
Oracle Cloud 生成AI PoC環境構築サービスでは、企業データの活用を検証するための生成AI基盤をお客様のOCI環境に迅速に導入します。また、導入した生成AI基盤での検証をサポートする技術支援オプションを提供します。
本サービスについての代表的なユースケースについてもご紹介します。